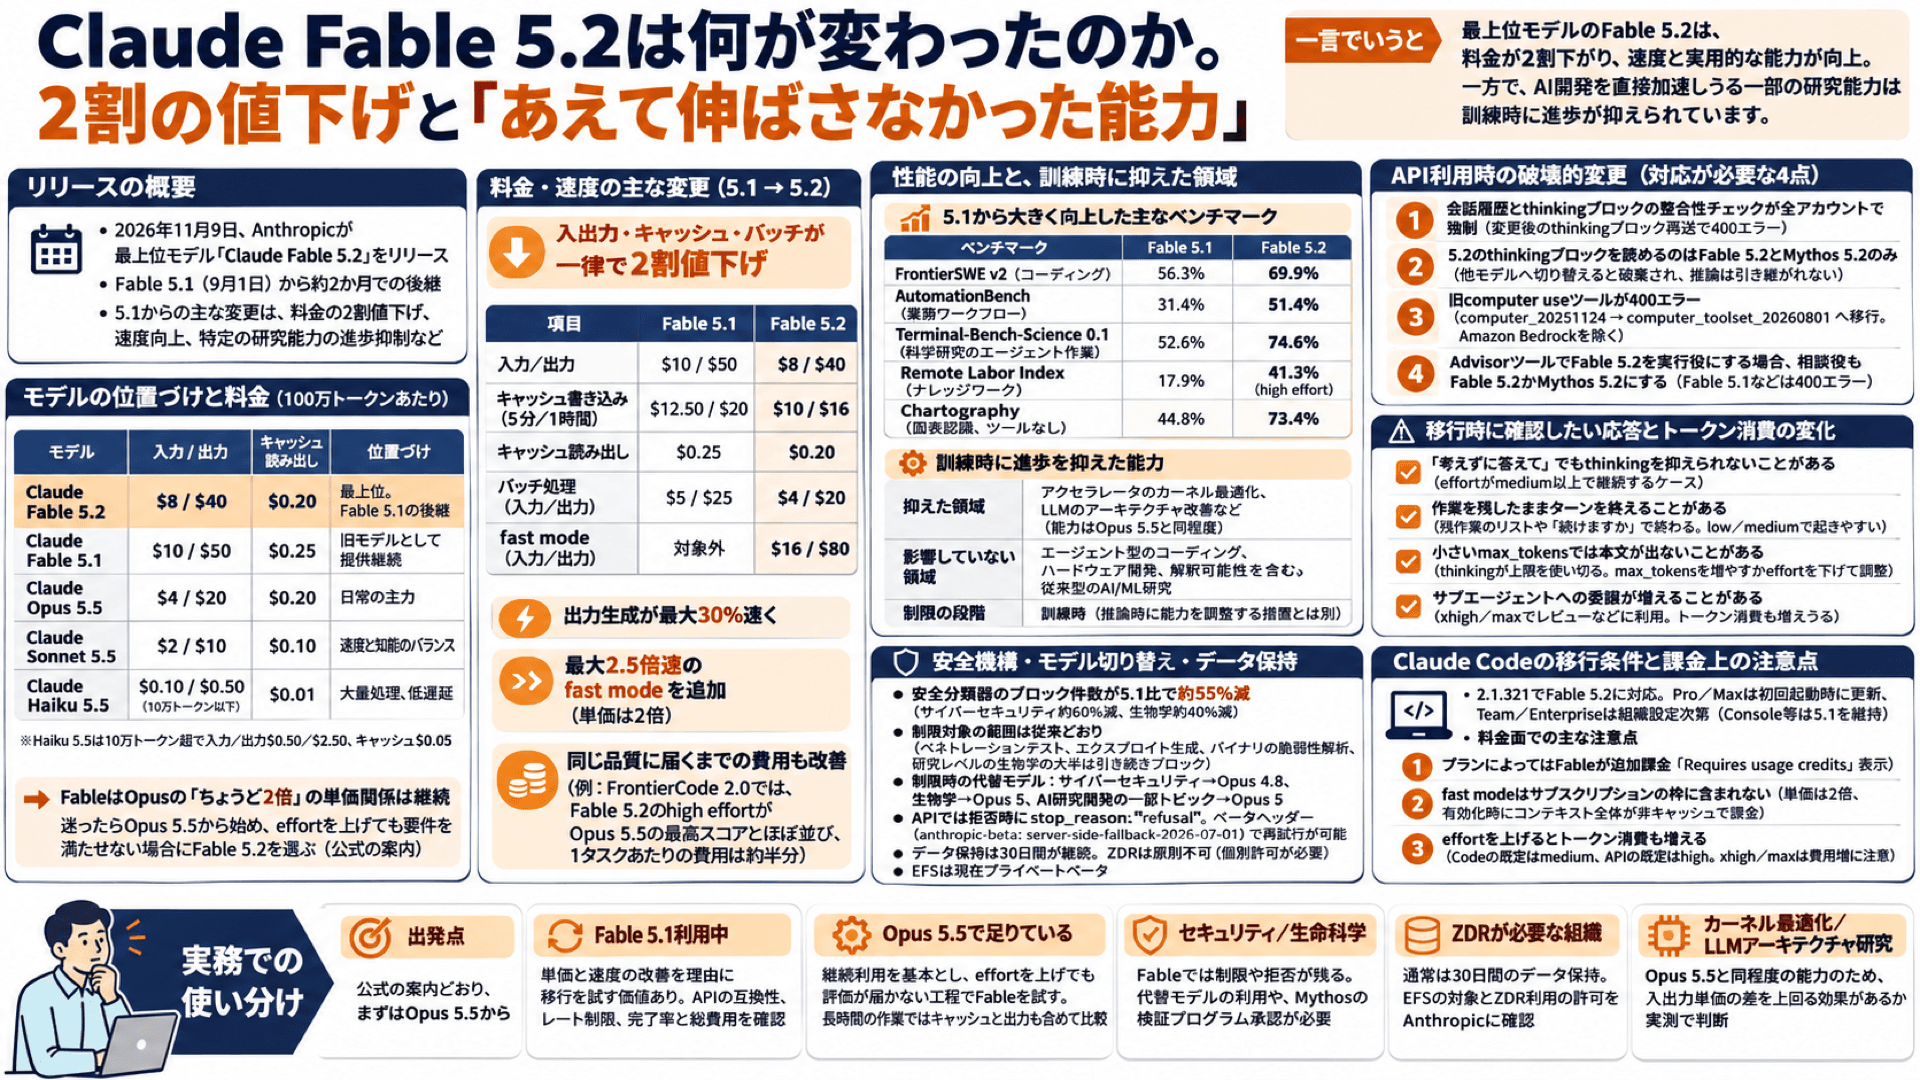
2026年11月9日、AnthropicがClaudeの最上位モデル「Claude Fable 5.2」をリリースしました(公式発表)。 9月1日のFable 5.1から約2か月での後継です。
この記事では「Fable 5.1から何が変わったのか」に絞って整理します。 情報は2026年11月10日時点の公式発表、公式ドキュメント、料金表をもとにしています。 ベンチマークの数値はすべてAnthropicの公表値です。
Fable 5.1からの主な変更
- 標準の入出力、キャッシュ、バッチの単価が2割下がった。 100万トークンあたりの入力 / 出力は$10 / $50から$8 / $40へ。 出力生成は最大30%速くなり、最大2.5倍速のfast modeも追加された
- 長時間の自律作業や図表の読み取りなどが改善した一方、AI開発を直接加速しうる一部の研究能力は、訓練時に進歩が抑えられた
- 自前でAPIを組み込む場合は、5.1からの破壊的変更4点を確認する。 Claude Codeは2.1.321以降で対応
変更点1:Opus 5.5と比べた位置づけ
11月10日時点の主なモデル構成と、Claude APIの100万トークンあたりの標準料金です。 金額は米ドルで、地域指定などの追加料金は含めていません(公式料金表)。
| モデル | 入力 / 出力 | キャッシュ読み出し | 位置づけ |
|---|---|---|---|
| Claude Fable 5.2 | $8 / $40 | $0.20 | 最上位。Fable 5.1の後継 |
| Claude Fable 5.1 | $10 / $50 | $0.25 | 旧モデルとして提供継続 |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 日常の主力 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 速度と知能のバランス |
| Claude Haiku 5.5 | $0.10 / $0.50 | $0.01 | 大量処理、低遅延 |
Haiku 5.5の値は、キャッシュ分を含む入力が10万トークン以下の場合です。 超えるリクエストでは入力 / 出力が$0.50 / $2.50、キャッシュ読み出しが$0.05になります。
前回の記事で比べたOpus 5に代わり、今回はOpus 5.5と比較します。 Fableは5.1から5.2で、Opusは5から5.5で入出力単価が2割下がったので、「FableはOpusのちょうど2倍」という関係は変わっていません。 キャッシュ読み出しは、前回のFable 5.1とOpus 5の比較ではFableのほうが安かったのに対し、今回は同額の$0.20で並びます。
公式は、迷ったらOpus 5.5から始め、推論にかける量を調整するeffortを上げても要件を満たせない場合にFable 5.2を選ぶ、と案内しています(モデル一覧)。
変更点2:入出力とキャッシュの単価が2割下がった
5.1の値下げはキャッシュ読み出しの1か所だけでした。 5.2は、標準の入出力、キャッシュ、バッチの各単価が同じ比率で下がっています。 以下も100万トークンあたりの料金です。
| 項目 | Fable 5.1 | Fable 5.2 |
|---|---|---|
| 入力 / 出力 | $10 / $50 | $8 / $40 |
| キャッシュ書き込み(5分 / 1時間) | $12.50 / $20 | $10 / $16 |
| キャッシュ読み出し | $0.25 | $0.20 |
| バッチ処理(入力 / 出力) | $5 / $25 | $4 / $20 |
| fast mode(入力 / 出力) | 対象外 | $16 / $80 |
発表では、値下げの理由は示されていません。
前回の記事に合わせて、20万トークンの共通入力を50回読み出すケースを試算します。 今回は初回のキャッシュ書き込み料金も含めます。 共通入力を5分キャッシュに1回書き込み、その後は有効期限内に読み出して期限を更新します。 出力はモデルの推論(thinking)を含めて合計10万トークンとします。 書き込み対象のトークンには書き込み単価が適用されるため、同じ20万トークンに通常の入力料金を重ねて足すことはしません(プロンプトキャッシュの料金)。
| 項目 | Fable 5.1 | Fable 5.2 | Opus 5.5 |
|---|---|---|---|
| 初回の5分キャッシュ書き込み 20万トークン | $2.50 | $2.00 | $1.00 |
| キャッシュ読み出し 1,000万トークン | $2.50 | $2.00 | $2.00 |
| 出力 10万トークン | $5.00 | $4.00 | $2.00 |
| 合計 | $10.00 | $8.00 | $5.00 |
5.1比では単価どおり2割減です(CodeKnightsの試算)。 Opus 5.5に対しては、入出力単価が2倍でも、この例の合計は1.6倍に縮まります。 読み出し単価が同じなので、同じトークン量で比較すると、キャッシュ読み出しの比率が高いほど費用の比率は1倍に近づきます。 キャッシュを使わず、入出力トークン数が同じなら料金は2倍です。 この試算には各ターンで追加される入力や会話履歴の書き込み、ツールの追加料金は含めていません。 実際のセッションではモデルごとに出力やツール呼び出しの量も変わるため、総費用は実測が必要です。
単価以外に、同じ品質に届くまでの費用も変わっています。 発表によると、コーディングの評価FrontierCode 2.0では、Fable 5.2のhigh effort(45.3%)がOpus 5.5の最高スコア(45.5%)とほぼ並び、1タスクあたりの費用は約半分でした。 単価が2倍でも、必要なトークン数が少なければ総額は逆転しうる例です。 この結果は当該評価の条件での比較であり、別の業務で半額になることを保証するものではありません。
fast modeは今回追加された選択肢です。 トークン生成が最大2.5倍速くなる代わりに、単価は2倍になります。
変更点3:性能が伸びた領域と、訓練時に進歩を抑えた領域
発表のベンチマークから、5.1との差が大きいものを抜き出します。
| ベンチマーク | Fable 5.1 | Fable 5.2 |
|---|---|---|
| FrontierSWE v2(コーディング) | 56.3% | 69.9% |
| AutomationBench(業務ワークフロー) | 31.4% | 51.4% |
| Terminal-Bench-Science 0.1(科学研究のエージェント作業) | 52.6% | 74.6% |
| Remote Labor Index(ナレッジワーク) | 17.9% | 41.3%(high effort) |
| Chartography(図表認識、ツールなし) | 44.8% | 73.4% |
公式表は、特記のない限り各モデルで利用可能な最高のeffortを使い、安全機構を有効にした結果です。 同じeffortや費用にそろえた比較ではありません(公式発表の評価条件)。
長時間の自律作業に加え、図表の読み取りにも大きな改善が見られます。 発表は、評価したほぼすべての能力でOpus 5.5を上回るとしています。 ただし全項目で首位ではなく、AutomationBenchではGemini 4 Carbon(53.9%)がFable 5.2を上回っています。
今回の発表には、訓練時に進歩を抑えた能力についても説明があります。 Anthropicは、AI開発を最も直接加速しうる特定の研究能力について、訓練時に進歩を抑える措置を取ったと説明しています。
- 進歩を抑えた領域:アクセラレータのカーネル最適化、LLMのアーキテクチャ改善など。 能力はOpus 5.5と同程度とされる
- 訓練変更の影響を与えていないとする領域:エージェント型のコーディング、ハードウェア開発、解釈可能性を含む従来型のAI/ML研究
- 制限を加えた段階:訓練時。 推論時に能力を調整する措置とは区別されている
この訓練上の措置は、Fable 5.2とMythos 5.2に共通するモデルに施されています。 公式の説明からは、通常のWeb開発で使うコーディング能力を抑える措置とは読み取れません。 個々の業務への影響はこの説明だけでは判断できず、特定トピックで別モデルに切り替える仕組みも残っています。
変更点4:安全機構によるブロック件数とモデル切り替え
安全分類器の誤検知を減らす改良も進んでいます。 発表によると、ブロック件数は5.1比で約55%減りました。 内訳はサイバーセキュリティが約60%減、生物学が約40%減です。 claude.ai、Claude Code、Coworkでの早期テストに基づく数字です。
一方、制限対象の範囲は従来と同様です。 ペネトレーションテスト、エクスプロイトの生成、バイナリの脆弱性解析と、研究レベルの生物学の大半は引き続きブロックされます。 公式発表で示されている代替モデルは次のとおりです。
| 領域 | 差し替え先 |
|---|---|
| サイバーセキュリティ | Opus 4.8 |
| 生物学 | Opus 5 |
| AI研究開発の一部トピック | Opus 5 |
3つ目は従来のモデルにもあった仕組みで、特定の非標準アクセラレータ向けのカーネル開発などが該当します。 これは前節の訓練上の措置とは別です。
Claude Codeには、安全分類器が検知したリクエストでモデルを自動的に切り替える仕組みがあります。
APIを直接呼ぶ場合は、通常はHTTP 200の応答に stop_reason: "refusal" が返るため、再試行の実装またはフォールバックの設定が必要です。
Claude APIのベータ機能では、ヘッダーに anthropic-beta: server-side-fallback-2026-07-01 を付け、fallbacks: "default" を指定すると、推奨モデルがあるカテゴリではそのモデルで再試行します(Refusals and fallback)。
Fableを指定していても別モデルが応答することがあるため、APIでは応答の model を確認します。
30日間のデータ保持要件は5.2でも続いています。 ゼロデータ保持(ZDR)の契約では、Anthropicが個別に許可しない限り使えません。 顧客側のインフラにデータを保存して安全監視を行うEnterprise Frontier Safeguards(EFS)は、現在プライベートベータです。 対象顧客は、EFSの監視を導入する前もZDRで利用を続けられると案内されています(公式発表のデータ保持に関する説明)。
同時発表のClaude Mythos 5.2は、Fable 5.2と同一の基盤モデルを使い、サイバーセキュリティと生物学に関する特定の安全対策を外した版です。 前節の訓練上の措置や、AI研究開発の一部トピックでのモデル切り替えはMythosにも適用されます。 料金は同じで、利用できるのは検証プログラムで承認された組織に限られます。
変更点5:API利用者が対応すべき破壊的変更4つ
自前でAPIのループを組んでいる場合は、モデルIDを claude-fable-5-2 に差し替える前に次の4点を確認します。
ここでは主にClaude APIのMessages APIでの変更を扱います(What's new in Claude Fable 5.2)。
- 会話履歴とthinkingブロックの整合性チェックが全アカウントで強制される。
system、tools、過去のメッセージを変更したうえで、その変更箇所より後に生成されたthinkingブロックを再送すると、Messages APIは既定で400エラーになる。 Fable 5.1では、既定でエラーになるのは2026年8月31日以降に作られたアカウントだった - 5.2のthinkingブロックを読めるのは、Fable 5.2とMythos 5.2だけ。 5.1やOpus 5.5へ切り替えると、読めないthinkingブロックは破棄される。 リクエスト自体は成功するが、破棄された推論は引き継がれない
- 旧computer useツールが400エラーになる。
computer_20251124からcomputer_toolset_20260801へ移行する(Amazon Bedrockを除く) - AdvisorツールでFable 5.2を実行役にする場合、相談役もFable 5.2かMythos 5.2にする。
Fable 5.1などを指定すると400エラーになる。
相談役のモデル変更も
toolsの変更に当たるため、新しい会話で切り替える
影響が大きいのは1です。 古いアカウントで整合性チェックのエラーを免れていた実装も、5.2では修正が必要です。 毎ターン注意書きを差し込んで次のリクエストで消す実装や、会話の途中でsystemプロンプトを組み直す実装が該当します。 Claude Code、claude.ai、Managed Agents、Agent SDKにリクエストの構築を任せている場合、この整合性チェックの変更に伴う対応は不要とされています。 発表はこの変更を、モデルの蒸留を防ぐ対策の一部と説明しています。
履歴を追記専用にするのが基本ですが、暫定対応として無効なthinkingブロックを破棄して続行する設定もあります。
thinking-binding-controls-2026-08-01 ベータヘッダーを付け、thinking.block_binding.prefix_mismatch_behavior を "drop_block" にします。
ただし、推論をやり直して出力トークンが増える可能性があるため、履歴を書き換える実装を直すまでの措置です(移行ガイド)。
破壊的変更とは別に、Fable 5.2のレート制限はFable 5.1やFable 5とは独立しています。 本番の処理を移す前に、新モデル側の上限も確認します。
コンテキスト100万トークン、最大出力128Kトークン、adaptive thinkingの常時オン、強制ツール呼び出しの400エラーは、5.1から変わっていません。
移行時に確認したい応答とトークン消費の変化
5.1からの挙動変化として、公式のプロンプトガイドと移行ガイドが注意点を挙げています(Prompting Claude Fable 5.2、移行ガイド)。 運用に直結するものを4つ紹介します。
「考えずに答えて」という指示では、thinkingを抑えられないことがあります。 Anthropicのテストでは、effortがmedium以上のとき、この指示を入れてもモデルは推論を続けました。 応答を速くしたい場合は、プロンプトではなくeffortを下げます。
作業を残したままターンを終えることがあります。 長い多段階のタスクで、残作業のリストや「続けますか」という申し出で終わるケースです。 lowとmediumで起きやすいとされています。
小さい max_tokens では本文が出ないことがあります。
thinkingが上限を使い切り、テキストが1文字も返らないケースです。
thinkingも上限に含まれるため、max_tokens を増やすかeffortを下げて調整します。
サブエージェントへの委譲を促す構成では、その利用が増えることがあります。 xhighやmaxでは、自分の成果物をレビューさせるためにサブエージェントを起動する例が観測されています。 並列処理やレビューに役立つ一方で、トークン消費も増えうるため、利用頻度と効果を確認します。
5.1向けのプロンプトを移す際は、完了率、費用、待ち時間を改めて測定します。
Claude Codeの移行条件と課金上の注意点
Claude CodeはFable 5.2に2.1.321で対応しました(モデル設定)。
保存済みのFable 5.1の選択が自動的に5.2へ移る条件は、契約と設定場所で異なります。
ProとMaxでは、このバージョン以降の初回起動時にユーザー設定が更新されます。
TeamとEnterpriseでは組織設定次第で、後日の起動時に移る場合や移らない場合があります。
Consoleアカウント、外部プロバイダー、プロジェクト設定などは5.1を維持します。
更新後は /model で実際の選択を確認します。
Claudeのサブスクリプション各プランでは、独自の設定がなければOpus 5.5が既定です。
Fable 5.2を選ぶには、通常は /model fable を使います。
料金面では次の3点に注意が必要です(モデル設定、fast mode)。
1. プランによってはFableが追加課金になる
該当する場合、モデル選択画面に「Requires usage credits」と表示されます。
-p での非対話実行と、確認画面を出さないAgent SDKアプリケーションでは、usage creditsへの課金条件を満たすと確認なしで課金されます。
Agent SDK全体で確認が省かれるわけではなく、画面を出すかどうかはアプリケーション側の実装次第です。
発表はリリース週の案内として、ProプランとTeamプランの標準seatでは週間利用上限の最大50%までFableが含まれるとしています。
これはリリース時の施策で、恒常的な利用枠とは分けて確認します。
2. fast modeはサブスクリプションの枠に含まれない
単価は標準の2倍です。 会話内で初めて有効にすると、その時点のコンテキスト全体がfast modeの非キャッシュ入力料金で課金されます。 標準速度とはキャッシュが別なので、その後も切り替えるたびに一部または全部を非キャッシュで読み直すことがあります。 使うならセッションの開始時に有効にします。
3. effortを上げるとトークン消費も増える
Claude CodeでのFable 5.2の既定はmediumですが、Claude APIの既定はhighです(APIのモデル仕様)。 APIで調整した設定をClaude Codeへそのまま当てはめず、使う環境ごとに比較します。 xhighやmaxは推論量に加え、前節のようにサブエージェントの利用が費用を増やす場合もあります。 高いeffortは、品質の改善を確認できる工程で使います。
実務でどう使い分けるか
公式の案内どおり、出発点はOpus 5.5です。
- Fable 5.1を使っている場合:単価と速度の改善を理由に、移行を試す価値がある。 APIの互換性、レート制限、実際のタスクでの完了率と総費用を確認してから切り替える
- Opus 5.5で足りている場合:継続利用を基本とし、effortを上げても評価が届かない工程でFableを試す。 長時間の作業でも、キャッシュの利用量と出力トークン数を含めて費用を比べる
- セキュリティや生命科学の業務:Fableの制限対象に当たる作業では、代替モデルへの切り替えや拒否が残る。 Mythosの利用には、用途に応じた検証プログラムの承認が必要
- ZDRが導入条件の組織:通常は30日間のデータ保持要件がある。 EFSの対象とZDR利用の許可をAnthropicの担当窓口に確認する
- アクセラレータのカーネル最適化やLLMアーキテクチャの研究:公式説明ではOpus 5.5と同程度の能力に留まるため、この用途だけでFableを選ぶなら、入出力単価の差を上回る効果があるかを実測する
参考リンク
- Claude Fable 5.2 and Claude Mythos 5.2(公式発表)
- Claude Fable 5.2 モデルページ
- What's new in Claude Fable 5.2
- Claude Fable 5.2 移行ガイド
- Prompting Claude Fable 5.2
- 料金表
- Prompt caching
- Refusals and fallback
- Claude Code モデル設定
- Claude Code fast mode
関連して読める記事
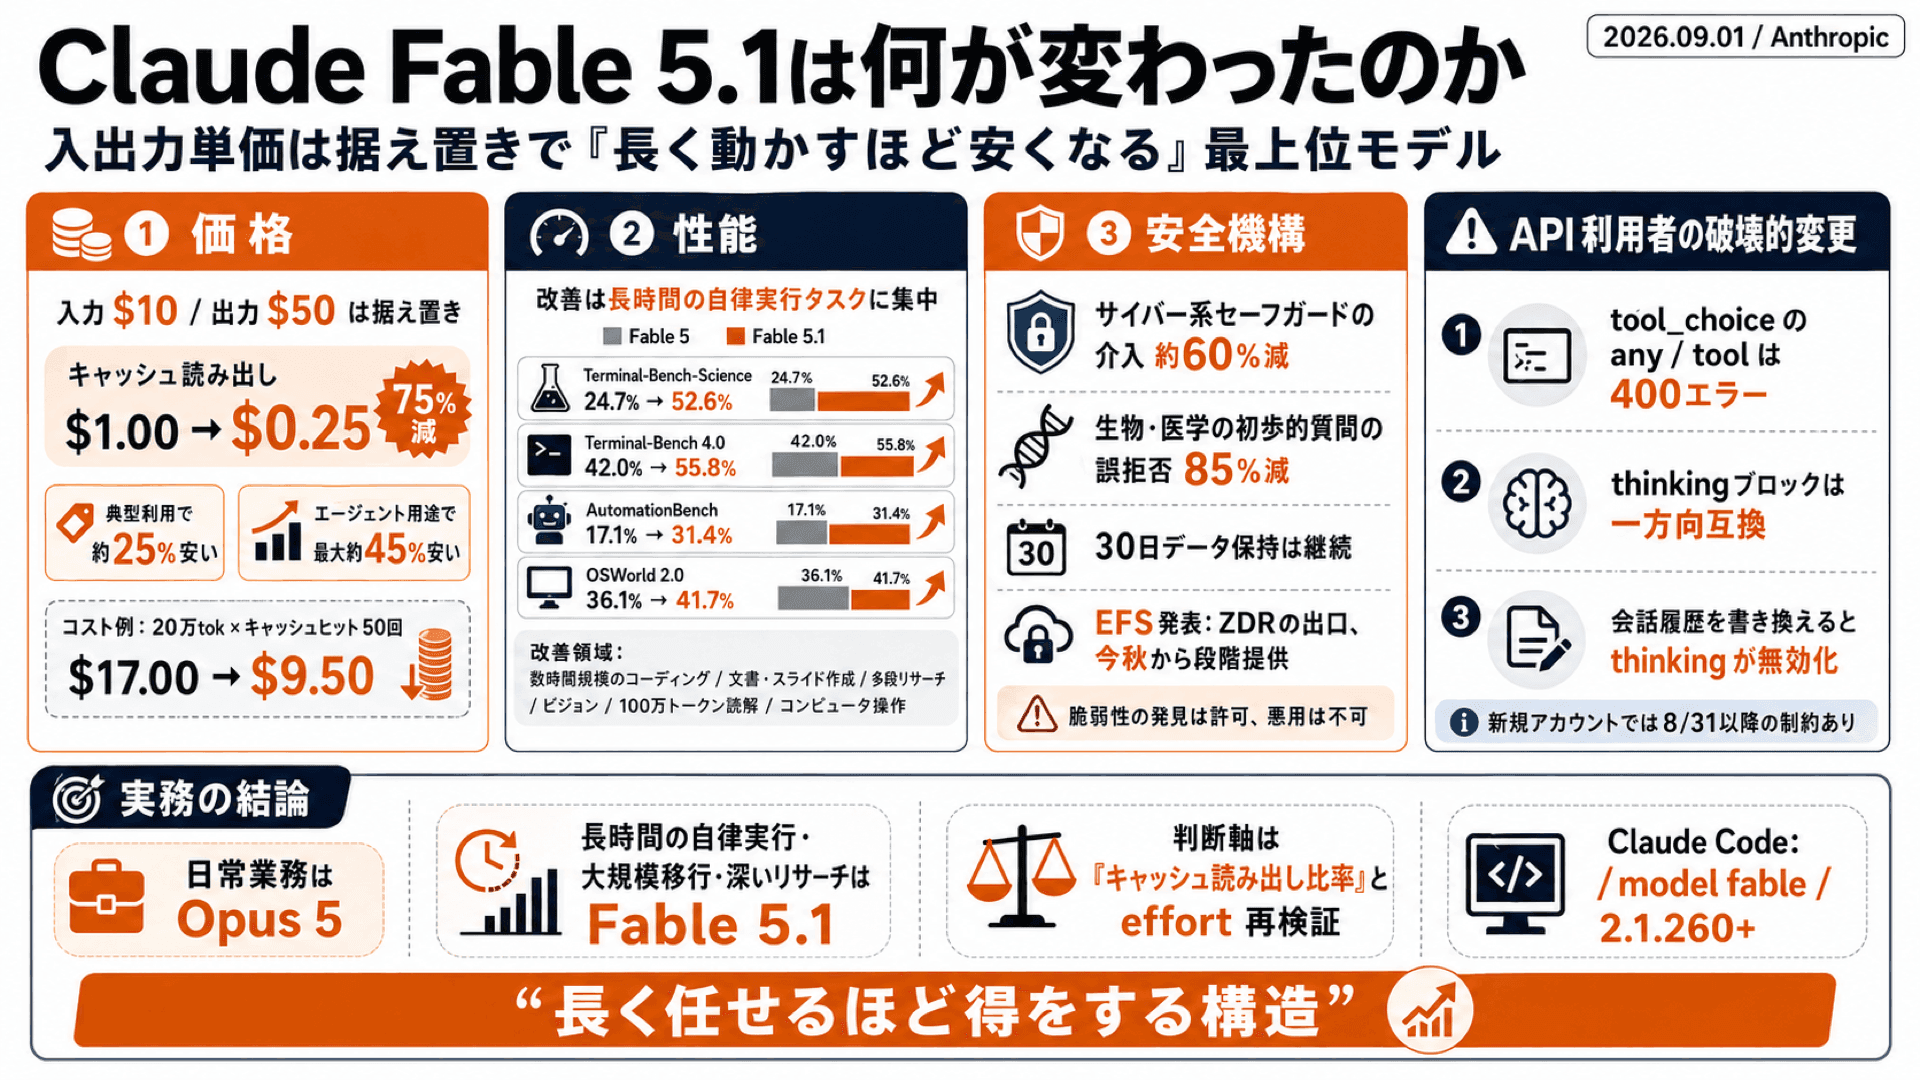
Claude Fable 5.1は何が変わったのか——入出力単価は据え置きで「長く動かすほど安くなる」最上位モデル
2026年9月1日にリリースされたClaude Fable 5.1の変更点を、Fable 5との差分だけに絞って整理します。入出力単価は据え置きのままキャッシュ読み出しを$1から$0.25に下げた価格改定の意味、長時間の自律作業に集中した性能向上、誤検知を減らした安全機構とZDRの出口となるEFS、強制ツール呼び出しの廃止や会話履歴の書き換え禁止といったAPI利用者向けの破壊的変更3つまでを解説します。
2026年9月4日
Claude Fable 5とは何か——リリース3日で米政府に規制された"Mythos級"モデルの、停止から復活までの全記録
2026年6月9日にリリースされたAnthropicの最上位モデル「Claude Fable 5」は、わずか3日後に米政府の輸出管理指令で提供停止となり、19日後の7月1日に復活しました。停止から復活までの経緯、価格とAPIの変更点、安全設計をめぐる論争、Opus 4.8やSonnet 5との使い分けまで、公式情報と報道を突き合わせて総まとめします。サブスクリプションでの無償利用は日本時間7月13日15時59分までです。
2026年7月8日